図面のDXF・PDF・TIFFで、読み取りの違いは?同じ架空図面20枚で比べた
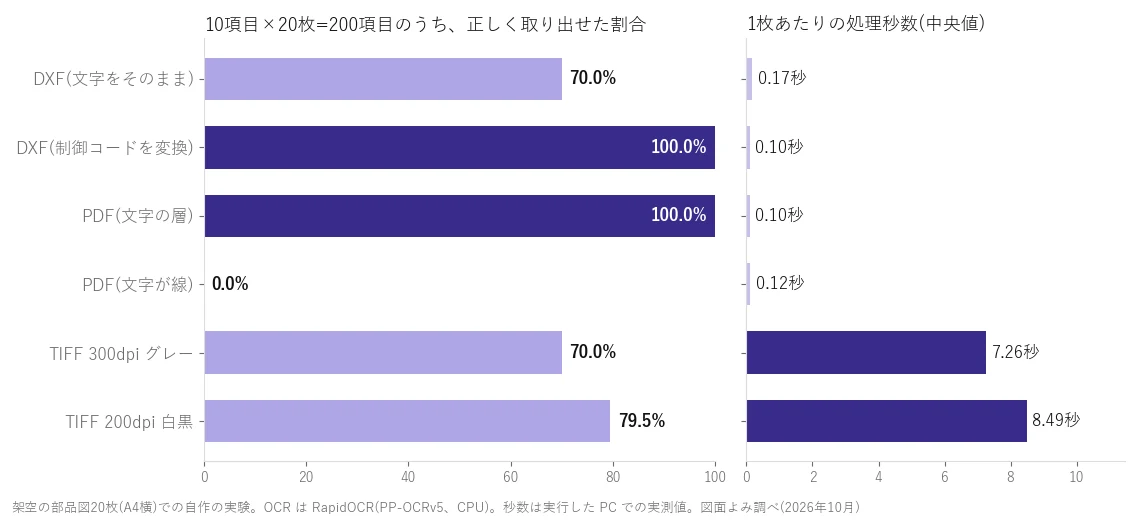
図面の読み取りの違いは、文字が「文字のデータ」として残っているかで決まります。DXFとCADから書き出したPDFは文字をそのまま取り出せるのでOCR(画像の文字を読む技術)が要らず、スキャンのTIFFは画像なのでOCRと読み違いの確認が要ります。図面よみが同じ架空図面20枚で比べると、200項目のうちDXF(記号の変換後)とPDFは全部、TIFFは70.0〜79.5%を正しく取り出せました。(2026年10月時点)
全体の流れと読める項目は読み取りの進め方のページにまとめています。
要点
- DXFと文字の層があるPDFは、架空図面20枚の200項目をすべて正しく取り出せ、1枚0.10秒でした。
- スキャン相当のTIFFをOCRで読むと、正しく取り出せたのは200項目の70.0〜79.5%で、1枚7〜8秒かかりました。
- TIFFでは直径の記号を「0」と読み、「φ16H7」を自信の値0.99で「016H7」と返しました。
- DXFでも、直径の「%%c」などの制御コードを変換しないと、200項目のうち70.0%しか合いません。
- 届いた図面は、まず形式と文字の層の有無で振り分け、OCRが要る図面だけ人の確認に回します。
目次
図面の形式で、読み取りはどう違うのですか?
違いは、文字が「文字のデータ」として残っているかどうかです。DXFとCADから書き出したPDFは文字をそのまま取り出せるので、OCRは要りません。スキャンのTIFFは画像です。OCRで読み、人が読み違いを確かめる手間が加わります。
同じ架空図面20枚を形式ごとに保存し、図番・材質・公差など10項目(計200項目)を取り出して比べました。文字が残る形式は全部取れて、画像の形式は7〜8割にとどまり、時間も70倍以上かかりました。読み取り全体の流れは読み取りの進め方にまとめています。
| 形式 | 中に入っているもの | OCR | 200項目の正解率(%) | 1枚の秒数(中央値) |
|---|---|---|---|---|
| DXF(制御コードを変換) | 線と文字のデータ | 不要 | 100.0 | 0.10 |
| PDF(文字の層あり) | 線と文字のデータ | 不要 | 100.0 | 0.10 |
| PDF(文字が線) | 線だけ | 必要 | 0.0(OCRなし) | 0.12 |
| TIFF 300dpi グレー | 画像 | 必要 | 70.0 | 7.26 |
| TIFF 200dpi 白黒 | 画像 | 必要 | 79.5 | 8.49 |
同じPDFでも、文字が線になっていると、文字の層がないので取り出せる文字は0字でした。形式の名前だけでなく、中身を見て振り分ける必要があります。
同じ図面20枚を形式ごとに読ませると、どれくらい差が出ましたか?
文字が残る形式は200項目すべてを1枚0.10秒で取り出せました。TIFFのOCRは70.0〜79.5%で、1枚7.26〜8.49秒かかりました。差がついたのは、直径の記号を含む寸法と注記です。
図面はPythonで作った架空の部品図(A4横)で、右下に表題欄を置きました。読むのは表題欄の6項目と、外形寸法(例:80±0.1)・穴(例:6-φ9)・はめあい(例:φ16H7)・注記です。
TIFFは、文字の層のあるPDFを300dpiのグレーと、傾きと汚れを足した200dpiの白黒にしました。OCRは社外に送らないRapidOCR(PP-OCRv5)です。ノートPC(Ryzen 7 7735U、CPUのみ)で動かしました。
取り出しの中心は数行です。DXFはezdxf、PDFはPyMuPDFを使いました。
doc = ezdxf.readfile(path)   # DXF:文字の要素を集め、書式と制御コードを外す
lines = [ln for e in doc.modelspace().query('TEXT MTEXT') for ln in e.plain_text().split('\n')]
text = fitz.open(pdf)[0].get_text()   # PDF:文字の層をそのまま読む
result = ocr(np.asarray(Image.open(tif).convert('RGB')))   # TIFF:OCRで読む
限界もあります。図面は1種類の様式で、文字はMSゴシックだけです。客先のCADや書体、手書きの書き込みが入れば、TIFFの結果はさらに変わります。乱数の種を固定しているので同じ図面を作り直せます。コードは相談のときにお見せします。
DXFなら、文字はそのまま正しく取れるのですか?
取れますが、CADの制御コードを変換しないと記号の入った寸法が合いません。直径の記号は「%%c」、±は「%%p」という文字列でDXFに入っているからです。変換しないまま読むと、200項目のうち70.0%しか合いませんでした。
外れたのは、外形寸法・穴・はめあいの3項目です。たとえば「φ16H7」は「%%c16H7」のまま取り出されます。ezdxfの plain_text() を通すと、制御コードと書式のコードが外れ、全200項目が合いました。
変換した後にも、もう1つ注意があります。ezdxf 1.4.4で変換した直径の記号は、ギリシャ文字のφではなくラテン文字の「Ø」でした。台帳で「φ」と打っている会社なら、照合の前に記号をそろえる処理を1行入れます。
複数行の注記(MTEXT)は、改行や書体の指定が文字列に混ざりますが、plain_text() で外れます。DWGは試していないので、ここでの結果はDXFに限った話です。
CADから書き出したPDFなら、OCRは要らないのですか?
文字の層が残っていれば要りません。ただ、書き出し方によっては文字が線(字の形の図形)になり、文字の層が残りません。この実験では、同じDXFを文字を線にしてPDFにすると、20枚とも取り出せた文字は0字でした。
文字の層があるPDFは、DXFと同じく200項目すべてを1枚0.10秒で取り出せました。PyMuPDFの公式ドキュメントも、OCRが要るページの目安を挙げています。ページ全体が画像で覆われている場合と、文字の代わりに小さな図形が数千並ぶ場合です。
見分け方は簡単です。PDFを開いて、図番の文字を選択できるか、検索で見つかるかを試します。選択できなければ、そのPDFはスキャンのTIFFと同じ扱いにして、OCRに回します。
書き出し方は客先ごとにほぼ決まっているので、最初の1枚で確かめて台帳に残しておきます。
スキャンのTIFFでは、どこを読み違えましたか?
いちばん多かったのは、直径の記号を数字の「0」と読む誤りです。「6-φ9」は「6-09」など、「φ16H7」は「016H7」になり、穴とはめあいは2つの条件とも20枚中0枚でした。表題欄の図番・品名・材質・表面処理・版数・尺度は、どちらの条件でも全部読めています。
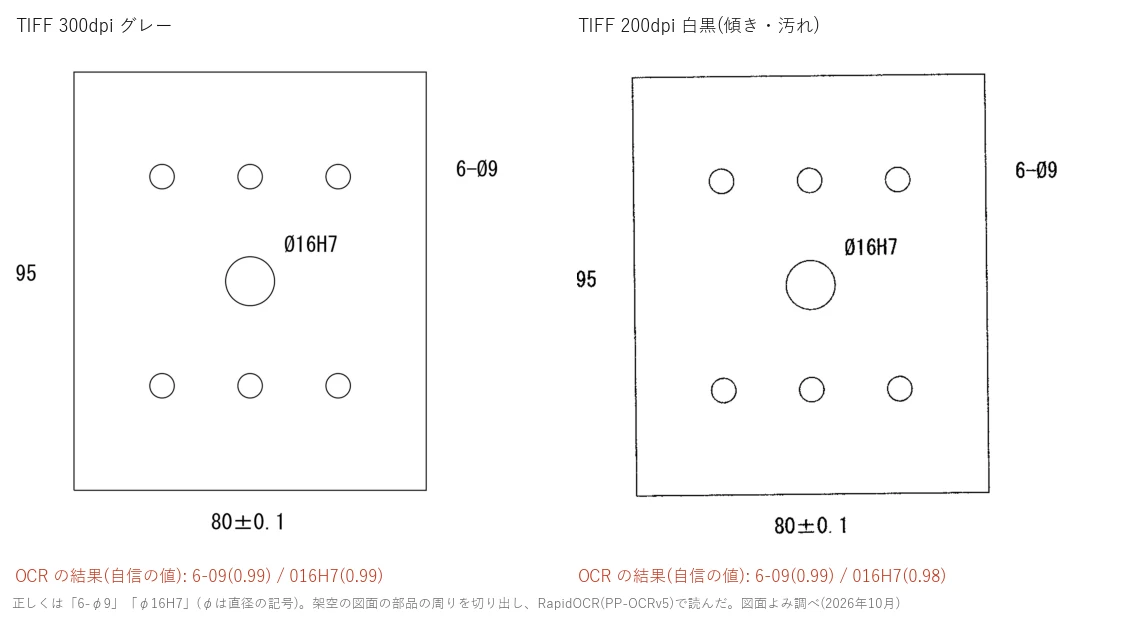
困るのは、OCRが自信の値0.99で「016H7」と返したことです。自信の低い所だけを人が見る仕組みでは、この誤りは素通りします。私が仕組みを作るときは、寸法の欄に決まりを足します。「数字が0で始まる」「穴数-径の形が崩れている」に当てはまれば、要確認に回します。
注記の「C0.5」は、200dpiで1枚だけ「CO.5」になりました。300dpiでは20枚とも「角」の後ろに余計な「I」が入り、注記の正解率は200dpiより低くなりました。解像度を上げても、誤りの出方が変わるだけのことがあります。
形式がばらばらな図面は、どう振り分ければよいですか?
まず形式で分け、PDFは文字の層の有無で分けます。文字が残る図面はOCRを通さずに取り出し、画像の図面だけをOCRと人の確認に回します。図面よみでは、受け取りの入口でこの振り分けをすることを、仕組みの最初の一歩にしています。
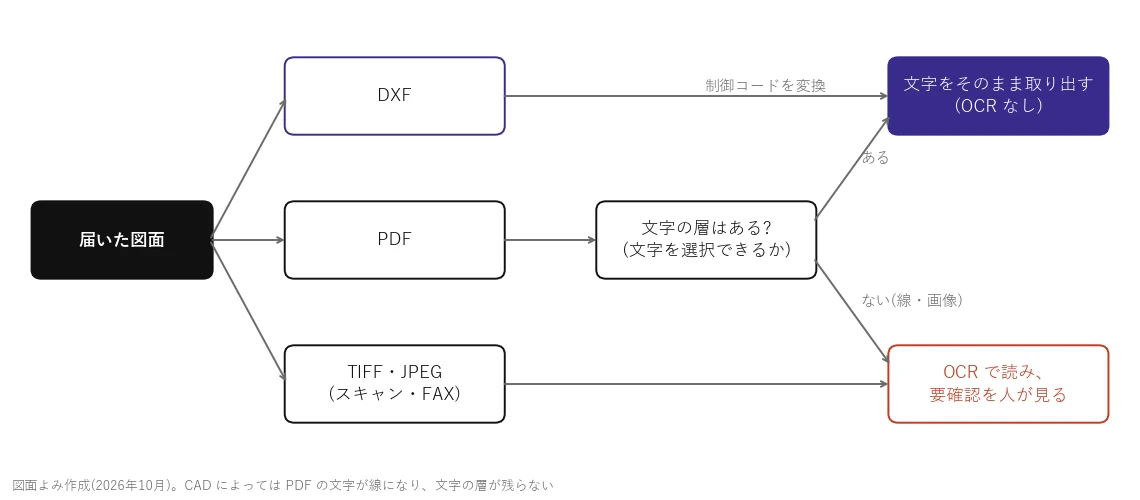
- 拡張子で、DXF・PDF・TIFFやJPEGに分ける
- DXFは制御コードを変換して文字を取り出し、直径の記号をそろえる
- PDFは文字の層があるかを確かめ、あれば文字をそのまま取り出す
- 文字の層のないPDFと画像は、OCRで読んで、寸法の決まりに合わない項目を要確認にする
- 客先ごとに、届く形式と文字の層の有無を台帳に残す
届く図面のうち画像の割合が分かれば、確認にかかる手間の大きさも見えてきます。方式ごとの比べ方は図面管理システムの比べ方に書いています。
STEPなどの3Dデータも一緒に届いたら、どう扱いますか?
2D図面と図番で結び付けて保管し、読み取りは2D図面から行います。見積と加工に使う材質・公差・表面粗さ・表面処理は、2D図面の表題欄と注記に書かれていることが多いからです。客先によっては、2D図面のPDFと一緒にSTEPやIGESの3Dデータを送ってくることがあります。
3Dデータに寸法や公差の注記を入れて渡す客先もあります。その場合も、2D図面と食い違いがないかを人が確かめます。どちらを正とするかは、客先との取り決めに従います。
3Dデータが役に立つのは、形で似た図面を探すときです。外形の大きさや体積のように、2D図面の画像からは取りにくい値を、3Dデータからは計算で取り出せます。今回の実験では3Dデータは試していないので、形で探す方法は類似図面検索の記事とあわせて読んでください。
| 届くもの | 図面よみでの使い道 | 結び付け方 |
|---|---|---|
| 2D図面(DXF・PDF・TIFF) | 図番・材質・公差・注記を読む | 台帳の1行の元 |
| 3Dデータ(STEP・IGES) | 形で似た図面を探す、外形の大きさを取り出す | 同じ図番・版数の行に、ファイルの置き場所を足す |
このサイトで相談するには?
客先から届く図面の形式に合わせて、読み取りの入口を作れます。図面よみの無料で相談するからどうぞ。何をどう頼むか決まっていなくても大丈夫で、準備は要りません。図面をお見せいただかなくても、御社のやり方に合わせて進め方を一緒に考えます。
よくある質問
- DWGで届いた図面も、文字をそのまま取り出せますか?
- この実験ではDWGを試していません。客先のCADでDXFに書き出してもらえれば、この記事と同じ方法で文字を取り出せます。
- PDFに文字の層があるかは、どう見分けますか?
- PDFを開いて、図番の文字を選択や検索できるか試します。選択できなければ、文字が線か画像になっていて、OCRが要ります。
- スキャンは300dpiにすれば十分ですか?
- 十分とは限りません。この実験では300dpiのグレーが70.0%、200dpiの白黒が79.5%で、差は注記の1項目の読み違いから出ました。
- 客先にDXFで送ってもらうよう頼むべきですか?
- 頼める客先には効果があります。CADデータを出さない方針の客先もあるので、文字の層を残したPDFで送ってもらうだけでもOCRが要らなくなります。
関連記事
出典
- ezdxf 公式ドキュメント「MText」(plain_text は書式コードを除いた文字を返す)(2026年10月16日確認)
- ezdxf 公式ドキュメント「Text」(2026年10月16日確認)
- ezdxf 公式ドキュメント「Tutorial for Getting Data from DXF Files」(エンティティの query)(2026年10月16日確認)
- PyMuPDF 公式ドキュメント「OCR - Optical Character Recognition」(OCRが要るページの見分け方)(2026年10月16日確認)
- PyMuPDF 公式ドキュメント「Text」(文字の取り出し)(2026年10月16日確認)
- 図面よみの実験(2026年10月16日)。架空の部品図20枚をDXF・PDF2種・TIFF2種で保存し、10項目の取り出しと処理秒数を比べた。ezdxf 1.4.4、PyMuPDF 1.27.2、RapidOCR 3.6.0(PP-OCRv5)。コードは相談のときにお見せします(2026年10月16日確認)