図面OCRの論文は何を測った?eDOCrの「90%」を評価の条件から読み、同じ指標で60枚を測る
図面OCRの論文eDOCr(2023年)の「検出の適合率・再現率90%、文字誤り率8%」は、図面7枚の寸法と幾何公差だけで測った数字です。3枚の図面では、表題欄と枠の上にある寸法・幾何公差の検出が採点から外されています。図面よみが同じ文字誤り率で架空の部品図60枚を測ると、寸法と公差は7.6%、表題欄は0.0%でした(CADのPDF)。製品の精度の表示も、何を何枚で測ったかを確かめてから読みます(2026年10月時点)。
全体の流れと読める項目は読み取りの進め方のページにまとめています。
要点
- eDOCr(2023年)の文字誤り率8%は、公開・非公開を合わせた図面7枚の寸法と幾何公差で測った平均です。
- 図面7枚の文字誤り率は3.4%〜14.1%と4倍の幅があり、うち3枚は表題欄と枠の上にある検出が採点から外されています。
- 同じ指標で架空の部品図60枚を測ると、CADのPDFで寸法と公差は7.6%、表題欄は0.0%と、採点する範囲で数字が変わりました。
- 製品の「精度○%」も、採点した項目・図面の枚数・指標の3つを確かめてから自社の図面と比べます。
目次
eDOCrの「90%」は、何を測った数字ですか?
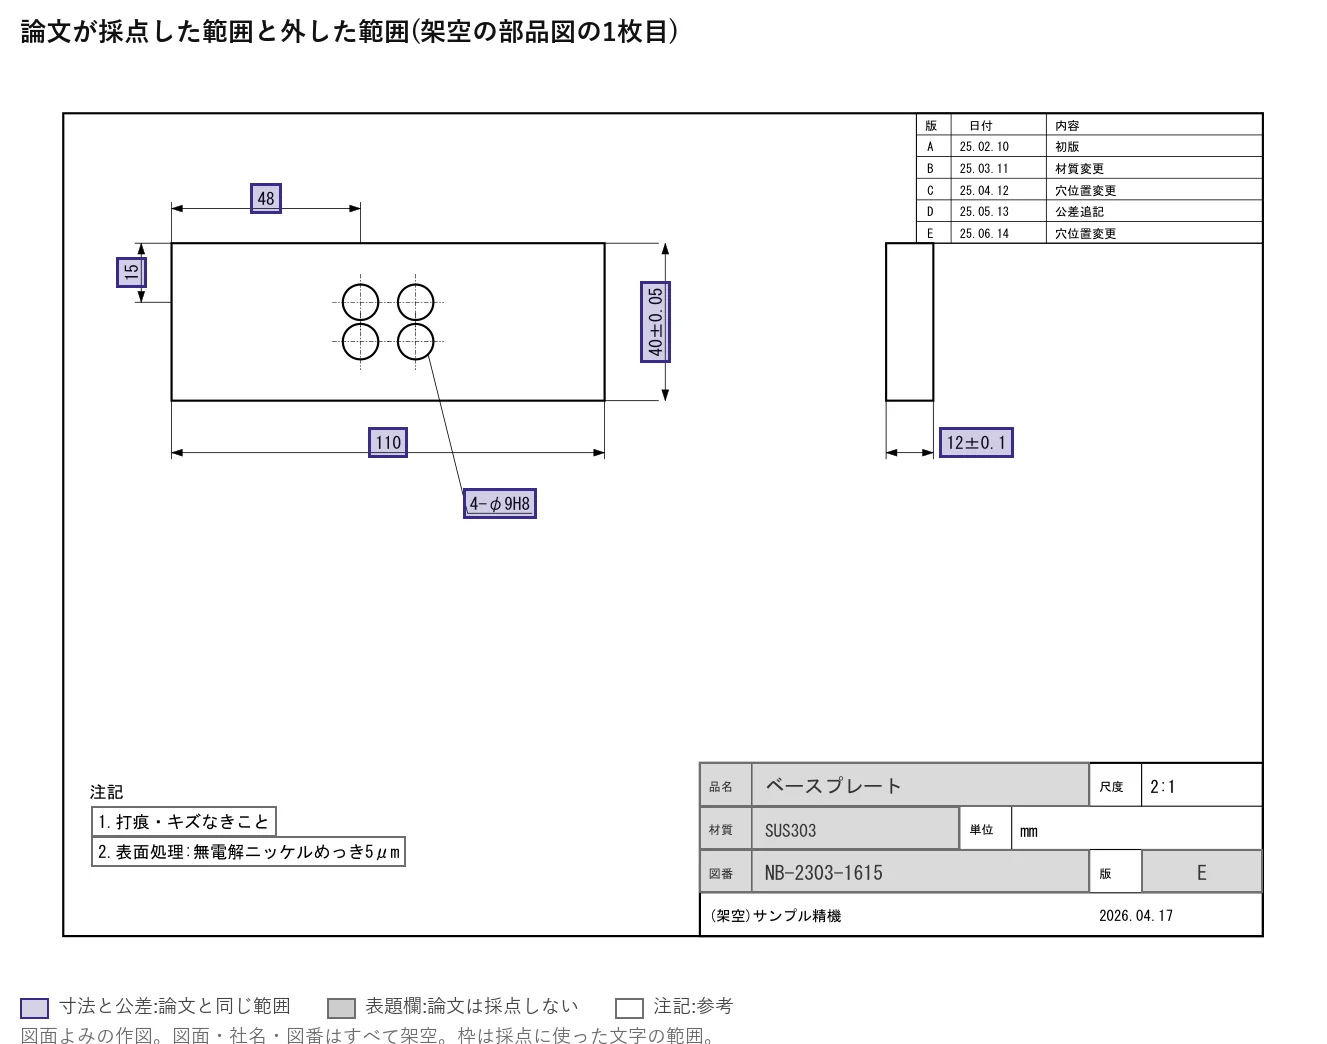
図面7枚の寸法と幾何公差を、どれだけ見つけて正しく読めたかの数字です。論文の5.3節は、Halter・Gripper・Adapterplatteの3図面で枠を検出できなかったと書いています。そのため、表題欄と枠の上にある寸法・幾何公差の検出は、この3図面の指標に含めていません。残り4図面の扱いは、本文から確かめられませんでした。図番・品名・材質が並ぶ表題欄の読み取りは、どの図面でも採点の主な対象ではありません。
論文は、スウェーデンのリンショーピング大学のVillena Toroらによるものです。2023年3月に『Frontiers in Manufacturing Technology』3巻で発表されました。要旨にある数字は、検出の適合率・再現率90%、認識のF1値94%、文字誤り率8%の3つです。評価の条件を原文から抜き出すと次の表になり、台帳づくりで読みたい項目の多くは測られていません。
| 確かめる点 | 論文の条件(原文の節) |
|---|---|
| 図面の枚数 | 7枚。1枚は協力企業のもので非公開(5.3節) |
| 図面の出どころ | 公開データ3枚、大学の実習用2枚ほか(5.3節) |
| 採点した文字 | 寸法と幾何公差の枠(5.3節) |
| 採点しない文字 | 3図面(Halter・Gripper・Adapterplatte)では、表題欄と枠の上にある検出(5.3節)。残り4図面は不明 |
| 指標 | 検出の適合率・再現率、F1値、文字誤り率(5.2節) |
| 採点の方法 | 人が手で数えた(5.3節) |
eDOCrは、どんな仕組みの図面OCRですか?
eDOCrは、機械部品の図面の画像から寸法・幾何公差・表題欄の文字を探して読み、3つの表に出すツールです。品質管理のために図面から要求事項を書き写す手作業を減らすのが目的です。文字を探す部分にはCRAFTという既存のモデルをそのまま使います。読む部分はkeras-ocrの認識モデルを、図面用の文字の種類に絞って学び直しています。
学習に使ったのは、白地に5〜10文字を並べて自動で作った画像です。認識モデルは寸法用・表題欄用・幾何公差用の3つで、表題欄用と幾何公差用はそれぞれ5万枚で学習しました。著者自身が「学習は収束していない」と書き、手で正解を付けた質の高いデータを作るのがいちばん効くと述べています。
著者が挙げた限界のうち、日本の受託加工の図面に関わるのは次の4つです。
- ベクターのPDFやDXFは読めず、画像に変えてから読む
- 表題欄は、外枠に接した箱の文字だけを読む
- 文字をまとめる閾値を図面ごとに調整する必要がある
- 「100」を「10」と読むように、同じ文字の連続が欠けやすい
認識の文字は数字・英字と「∅」「±」などの記号に絞っているので、品名や注記の日本語はもともと読む対象に入っていません。
図面7枚の文字誤り率は、どれくらいばらついていますか?
いちばん低い図面で3.4%、いちばん高い図面で14.1%と、4倍の幅があります。要旨の8%は、この7枚の値を平均した数字です。
文字誤り率は、OCRの出力と正解の文字列を比べ、置換・挿入・削除の数を正解の文字数で割った値です。論文の例では、正解「∅34.5」(5文字)を「∅84.5」と読むと置換1つで20%です。論文の表3にある7枚の値は、次の図のとおりです。
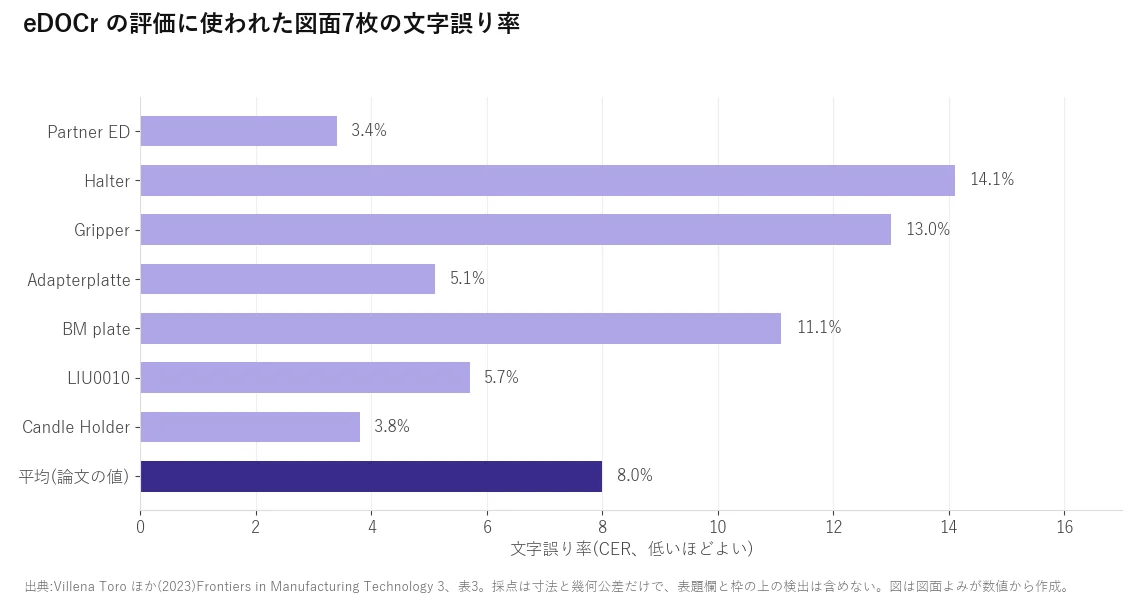
幅が出る理由として、論文は文字をまとめる閾値が図面ごとに合わないことを挙げています。BM plateという図面では、「1」がすべて丸かっこの開きに置き換わりました。7枚の平均だけを見ると、苦手な図面での誤りの多さが見えません。
同じ指標で架空図面60枚を測ると、どうなりますか?
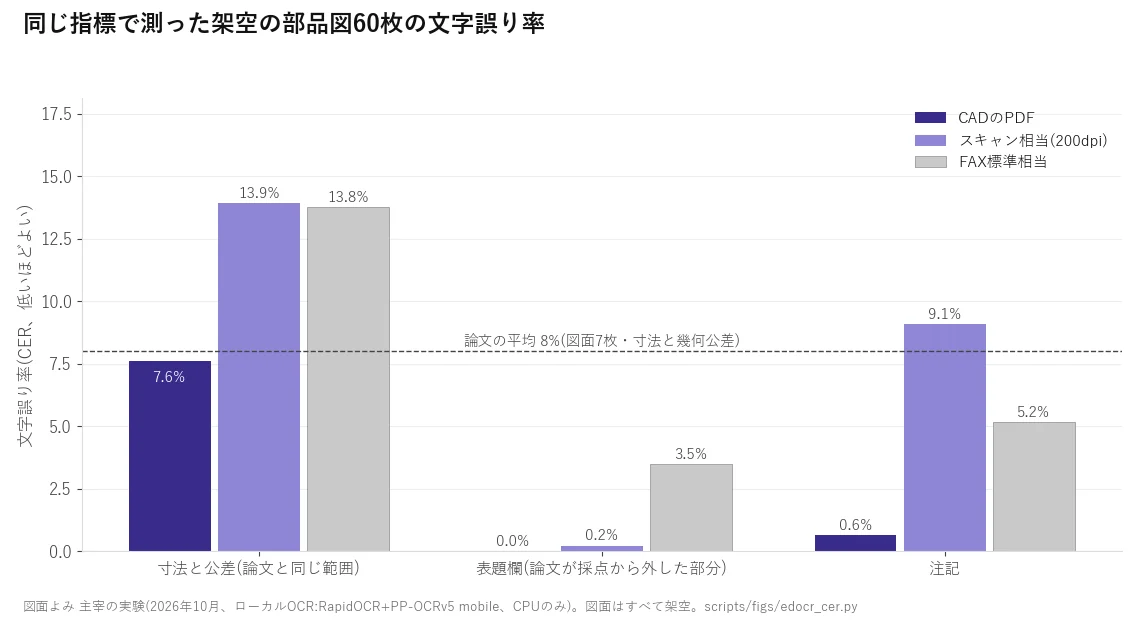
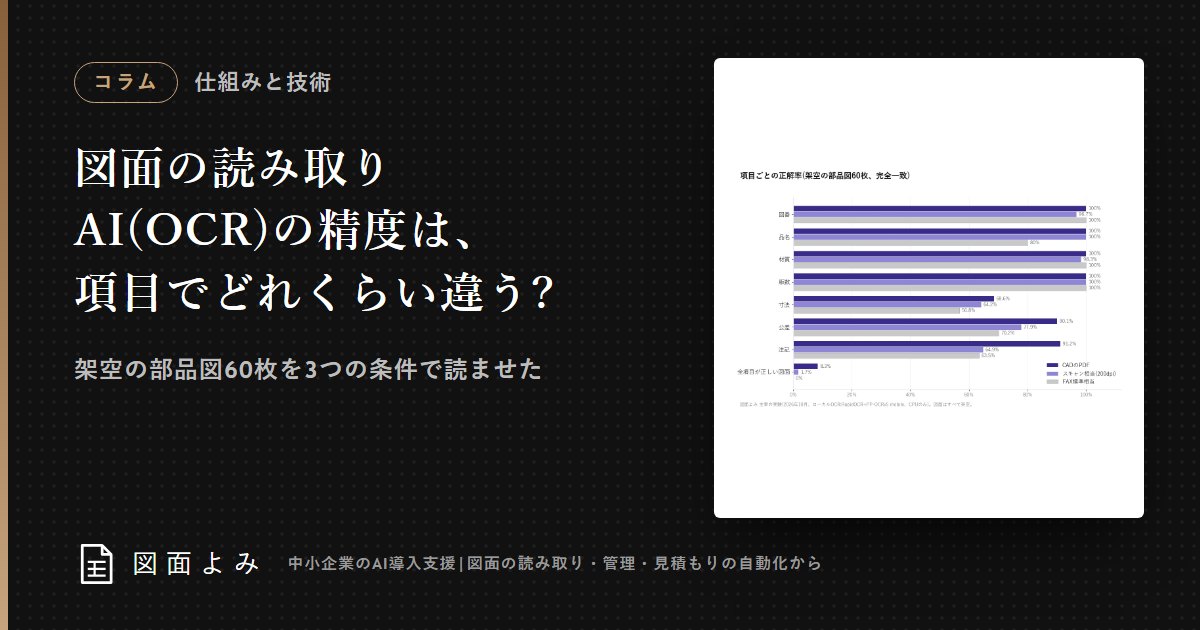
採点する範囲と図面の状態によって、文字誤り率は0.0%から13.9%まで動きました。図面よみが図面の読み取りAIの精度を測った記事と同じ60枚・3条件の読み取り結果から、論文と同じ式で計算した値です。OCRは社外に送らないローカルのRapidOCR(PP-OCRv5 mobile)で、eDOCrではありません。
範囲ごとに並べると次の表のとおりです。論文が一部の図面で外した表題欄は、CADのPDFとスキャン相当ではほとんど誤りがありませんでした。上下に積んだ公差は、上と下を読む順が逆でも正しいとみなしています。
| 図面の状態 | 寸法と公差 | 表題欄 | 注記 | 寸法と公差の全文字一致 |
|---|---|---|---|---|
| CADのPDF | 7.6% | 0.0% | 0.6% | 77.2% |
| スキャン相当(200dpi) | 13.9% | 0.2% | 9.1% | 69.2% |
| FAX標準相当 | 13.8% | 3.5% | 5.2% | 62.2% |
寸法と公差の誤りの多くは、縦の寸法線に沿って90度回した寸法から出ています。CADのPDFでは、横書きの寸法240個の文字誤り率が1.3%だったのに対し、縦向きの120個は28.8%でした。縦向きのうち31個は、何も読めていません。図面ごとの値も0%〜31.3%と開き、論文の7枚と同じく、平均だけでは苦手な図面が見えません。
def item_err(it):                       # 1項目の誤りの数と、正解の文字数
    g, t = norm(it['got']), norm(it['truth'])
    return lev(g, t), len(t)            # lev は置換・挿入・削除の最小回数
cer = sum(e for e, n in errs) / sum(n for e, n in errs)   # 範囲ごとに合計してから割る
使ったOCRと図面が論文と違うので、この比較からどちらが優れているかは言えません。60枚は1つの様式で作った架空の図面で、手書きや実物の汚れは入っていません。FAX標準相当の表題欄の誤り48文字のうち36文字は、値ではなく「図番」などの見出しを読み違えた分です。読み取りと計算はCPUで20〜40分かかりました。コードは相談のときにお見せします。
自社の図面で精度を確かめるには、何を決めればよいですか?
採点する項目、図面の枚数と選び方、指標の3つを先に決めます。論文の数字も製品の精度の表示も、この3つが自社の使い方と合っていなければ、そのまま当てはめられません。
- 台帳や見積に使う項目(図番・版数・材質・寸法など)を決め、採点する範囲を書き出す
- 客先・様式・状態(CADのPDF、スキャン、FAX)ごとに数枚ずつ選ぶ
- 正解の文字列を人が作り、文字誤り率と項目ごとの全文字一致の両方を出す
- 図面ごとの値も並べ、平均だけで判断しない
全文字一致を一緒に見るのは、図番や寸法は1文字違うと別物になるからです。文字誤り率が低くても、誤りが図番に集まれば台帳は使えません。
後継のeDOCr2は2025年に『Machines』誌で発表されています。原文を開けなかったため、ここでは数字を扱いません(2026年10月時点)。原文を確かめたら追記します。
このサイトで相談するには?
論文や製品の数字が自社の図面に当てはまるか気になる方は、図面よみの無料で相談するからどうぞ。何をどう頼むか決まっていなくても大丈夫です。準備は要りません。図面をお見せいただかなくても、御社のやり方に合わせて、確かめ方と進め方を一緒に考えます。
よくある質問
- 論文の「F1値94%」と「文字誤り率8%」は、どう違うのですか?
- F1値は読み取りの適合率と再現率を1つにまとめた値で、高いほどよい数字です。文字誤り率は正解の文字数に対する置換・挿入・削除の割合で、低いほどよい数字です。
- eDOCrはそのまま日本の図面に使えますか?
- いいえ。認識の文字は数字・英字と寸法の記号に絞って学習しており、品名や注記の日本語は読む対象に入っていません。表題欄も外枠に接する箱だけを読む作りです。
- 文字誤り率が低ければ、手直しは要りませんか?
- いいえ。文字誤り率が数%でも、1文字違えば寸法や図番は別物です。項目ごとの全文字一致の割合と、自信のない項目を人に回す仕組みを合わせて見ます。
- 自社の図面で精度を測るには、何枚あればよいですか?
- 決まった枚数はありません。論文は7枚でしたが、図面ごとの文字誤り率に4倍の幅がありました。客先・様式・状態(PDFかスキャンか)ごとに数枚ずつ選ぶと、偏りに気づけます。
関連記事
出典
- Villena Toro, J., Wiberg, A., Tarkian, M.「Optical character recognition on engineering drawings to achieve automation in production quality control」Frontiers in Manufacturing Technology 3(2023年3月20日、リンショーピング大学)。5.2節・5.3節・表3(2026年10月16日確認)
- Villena Toro, J., Tarkian, M.「Optimizing Text Recognition in Mechanical Drawings: A Comprehensive Approach」Machines 13巻3号 254(2025年、eDOCr2)。原文は開けず、数字は使っていない(2026年10月16日確認)
- 図面よみの実験(2026年10月16日)。架空の部品図60枚×3条件、ローカルOCR(RapidOCR+PP-OCRv5 mobile、CPUのみ)、文字誤り率を項目の範囲ごとに計算。コードは相談のときにお見せします(2026年10月16日確認)