過去の見積からAIで単価を予測すると、誤差は?架空の過去見積で件数と5つの方法を比べた
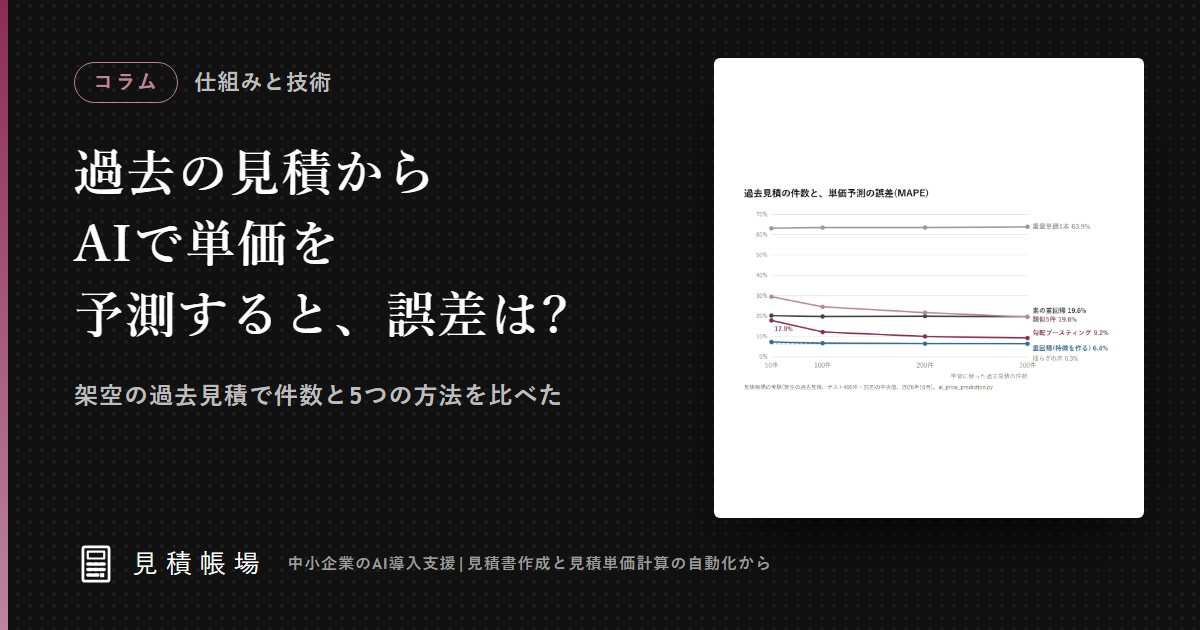
過去の見積からAIで単価を予測すると、誤差は件数と方法で大きく変わります。計算ルールにベテランの揺らぎ(約8%)を足した架空の過去見積で、テスト400件・20回の中央値を比べました。300件で学ぶと、平均の誤差は勾配ブースティングが9.2%、素の重回帰が19.6%、重量単価1本が63.9%です。計算の形を特徴にした重回帰は6.4%まで下がりました(2026年10月時点)。
全体の流れと費用は製造業の見積の自動化のページにまとめています。
要点
- 過去の見積からの単価予測は、件数が少ないと誤差が大きく、件数が増えるほど方法による差が開きます。
- 架空の過去見積300件で学ぶと、平均の誤差は勾配ブースティング9.2%、素の重回帰19.6%、重量単価1本63.9%でした。
- 1/ロットなど計算の形を特徴にした重回帰は6.4%で、揺らぎの床6.3%に近づきました。差を分けたのは方法より、計算の決まりを知っているかでした。
- 同じ勾配ブースティングでも50件では17.9%、100件で12.2%、200件で10.0%でした(テスト400件・20回の中央値)。
- 予測と積み上げの差が15%を超えた件を要確認にすると、300件で学んだ場合は7.5%が人の確認に回りました。
目次
過去の見積からAIで単価を予測すると、誤差はどれくらいですか?
架空の過去見積300件で学ぶと、平均の誤差は方法によって6.4〜63.9%の開きがありました。条件の列をそのまま入れる方法では勾配ブースティングの9.2%が最も小さく、重量単価1本で出すと63.9%です。50件しかないと、勾配ブースティングでも17.9%に広がります。計算の形(段取り÷ロットなど)を列にして足した重回帰は6.4%でした。
見積帳場が2026年10月に測った結果は、次の表のとおりです。誤差は平均絶対誤差率(MAPE)で、予測と過去見積の金額の差を、過去見積の金額で割った割合の平均です。学習用の過去見積を変えて20回ずつ測り、中央値を載せました。300件の勾配ブースティングは、20回で8.5〜9.9%の範囲に収まっています。
| 学習に使った件数 | 重量単価1本(%) | 素の重回帰(%) | 類似5件(%) | 勾配ブースティング(%) | 重回帰・特徴を作る(%) |
|---|---|---|---|---|---|
| 50件 | 63.2 | 20.3 | 29.5 | 17.9 | 7.3 |
| 100件 | 63.5 | 19.8 | 24.6 | 12.2 | 6.7 |
| 200件 | 63.5 | 20.0 | 21.7 | 10.0 | 6.5 |
| 300件 | 63.9 | 19.6 | 19.6 | 9.2 | 6.4 |
「素の重回帰」は、条件の列(材質・重さ・穴数・公差・ロット)をそのまま入れた形です。「特徴を作る」重回帰は、材質ごとの重さ・√重さ・公差×穴数・1/ロット・公差/ロットを列として足しました。架空データの作り方と同じ形の列なので、計算の決まりを知っていればここまで下がる、という上限の目安です。
公開された研究では、自動車部品の図面13,684枚から製造コストを予測した論文があります(arXiv:2508.12440、2025年8月、査読前)。誤差は全体でおおむね10%、部品のグループごとに3.91〜18.51%でした。使ったデータと予測する値が違うので、この表とは直接比べられません。
架空の過去見積は、どうやって作りましたか?
計算ルールで出した積み上げの金額に、ベテランの揺らぎを掛けて作りました。品物の条件は、材質3種・重さ・穴数・公差の厳しさ・ロット(1〜500個)の5つです。テスト400件の金額は、1,096円から21,093円まででした。
積み上げは、材料費(重さ×材質ごとの円/kg)と、加工と段取りの時間に時間単価6,000円を掛けた額の和です。段取りはロットで割ります。どの数字も架空です。
揺らぎはσ0.08の対数正規で、同じ品物でもおおむね±8%ずれる、というベテランの値決めを表しています。コードの要点は次の数行です。
t_min = 6 + 9 * w**0.5 + 1.5 * holes + 8 * tol + tol * holes       # 1個の加工(分)
setup_min = 45 + 20 * tol                                               # 段取り(分)
true = w * kg_price * 1.15 + (t_min + setup_min / lot) / 60 * 6000      # 積み上げ
vet = true * rng.lognormal(0, 0.08, n)                                  # 過去見積の金額
scripts/figs/ai_price_prediction.py を動かせば、種を固定しているので同じ数字が出ます。積み上げそのものを予測にしても、揺らぎがあるため誤差は6.3%残ります。どの方法も、この6.3%より下には行けません。
件数が増えると、どの方法の誤差が下がりますか?
件数とともに大きく下がったのは、勾配ブースティングと類似5件の2つでした。勾配ブースティングは50件の17.9%から300件の9.2%へ、類似5件は29.5%から19.6%へ下がっています。素の重回帰と重量単価1本は、件数を増やしてもほとんど変わりません。特徴を作った重回帰は、50件の時点で7.3%と低く、300件で6.4%でした。
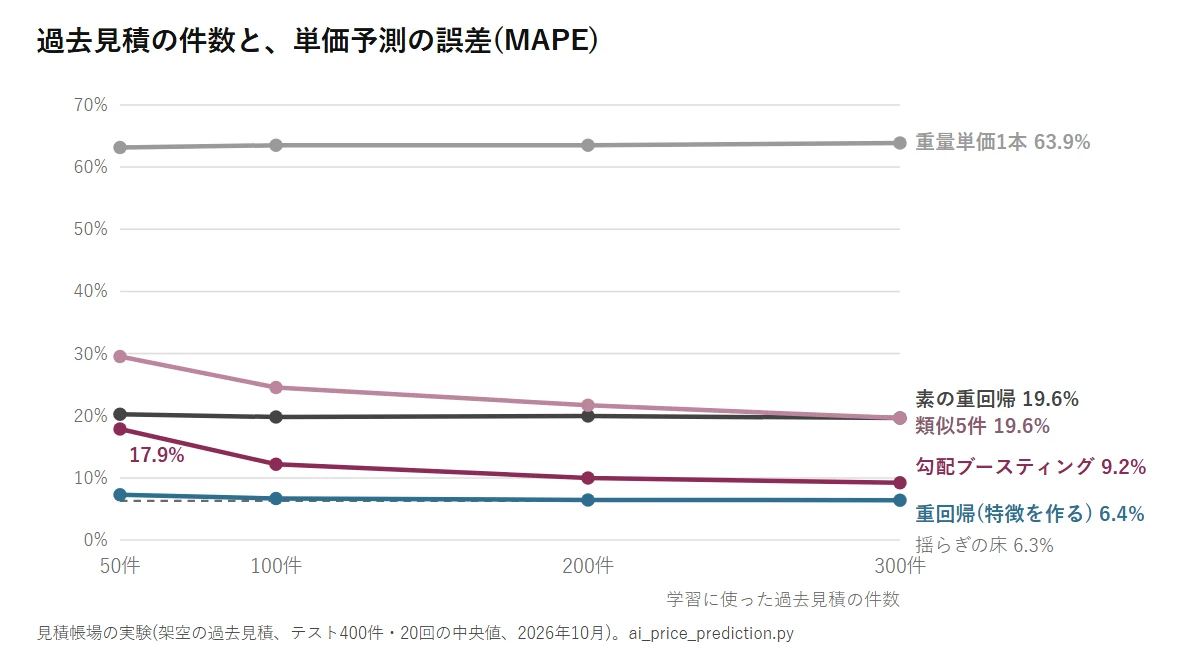
差が出た理由は、段取りの按分にあります。段取り時間をロットで割る計算は、ロットが小さいほど単価を急に押し上げます。素の重回帰は、与えた列の足し算の形でしか学べないため、件数を増やしてもこの曲がり方を表せず、約20%で止まりました。これは重回帰という方法の限界ではなく、列の作り方の結果です。1/ロットや公差/ロットの列を足すと、同じ重回帰が6.4%まで下がりました。
勾配ブースティングは、列を作らなくても条件を細かく区切って学ぶので、件数が増えるほど曲がり方に近づきます。逆に言えば、社長の計算の決まり(段取りはロットで割る、など)を書き出せれば、少ない件数でも単純な方法で揺らぎの床に近づけます。予測の前に決まりを書き出す意味は、ここにあります。
重量単価1本の予測は、なぜ大きく外れるのですか?
重さ以外の条件を見ないからです。重量単価1本は、過去見積の円/kgの中央値に重さを掛けるだけなので、穴数・公差・ロットの違いが金額に入りません。300件で学んでも、誤差は63.9%でした。
外れ方には向きがあります。軽い小物は加工と段取りの分が金額の大半なのに、重さが小さいので安く出すぎます。重い品物は逆に高く出すぎます。
同じ重さでも、1個だけの試作と500個の量産では段取りの按分が大きく違いますが、重量単価ではどちらも同じ金額になります。めっきのように重量単価で見積を出す業種では、この外れ方が実務の赤字に直結します。
予測した単価を、そのまま見積に使ってよいですか?
そのまま使うのはおすすめしません。平均で9.2%でも、外れの大きい件が残るからです。私が仕組みを作るときは、計算ルールの積み上げと予測の金額を並べます。差が大きい件だけを「要確認」として人に回します。
勾配ブースティングで、予測と積み上げの差がどこを超えたら要確認にするかを変えて測りました。300件で学んだ場合、差15%超で線を引くと、テスト400件の7.5%が要確認に回ります。誤差が20%を超えた件のうち、要確認で拾えたのは47%でした。
| 学習の件数 | 要確認にする差 | 回る割合(%) | 誤差20%超のうち拾えた割合(%) | 回らなかった件の誤差(%) |
|---|---|---|---|---|
| 300件 | 10%超 | 18.4 | 72.3 | 7.4 |
| 300件 | 15%超 | 7.5 | 46.7 | 8.0 |
| 300件 | 20%超 | 3.5 | 29.9 | 8.4 |
| 100件 | 15%超 | 21.0 | 71.9 | 8.7 |
線を下げるほど誤りは拾えますが、人の手間が増えます。100件しかない段階では、差15%超でも21.0%が要確認に回りました。値引き・特急・材料の時価のように、計算ルールにない事情で金額を変えた見積は、予測と積み上げのどちらでも拾えません。
自社の過去見積で試すとき、何に気をつけますか?
まず、材質・寸法・数量などの条件が列になっているかを確かめます。この実験は5つの条件がそろった架空データです。実際の過去見積では品名や備考に条件が埋もれていることが多く、列に起こす作業が先に要ります。
ほかに、この実験に入っていないことが3つあります。材料の値上がりのように時期で変わる金額、失注した見積と受注した見積の違い、計算ルールにない値引きです。どれも誤差を大きくする方向に働くので、自社のデータでは表の数字より悪くなりえます。
試すときは、学習に使わない見積を数十件残し、予測と実際の金額を1件ずつ並べます。平均の誤差だけでなく、20%を超えて外れた件数も数えます。数字の読み方は公開事例の数字を読み直した記事、積み上げの式は見積単価の計算方法の記事にあります。
予測の誤差を自社の見積で確かめるには?
見積帳場では、過去見積からの予測を、積み上げの金額と並べて差の大きい見積を見つける形で組み込めます。
何をどう頼むか決まっていなくても大丈夫です。御社のやり方に合わせて、進め方を一緒に考えます。準備は要りません。無料で相談するのページで受けています。
よくある質問
- 過去の見積が何件あれば、予測を使い始められますか?
- この架空データでは、勾配ブースティングの誤差が100件で12.2%、200件で10.0%でした。100件を下回るうちは、積み上げの点検に使う程度にします。
- Excelの過去見積に、材質や数量の列がなくても使えますか?
- そのままでは使えません。品名や備考に埋もれた材質・寸法・数量を列に起こしてから学ばせます。この実験は列がそろった前提です。
- ChatGPTに過去見積を渡して単価を出させるのと同じですか?
- いいえ。この実験の5つの方法は数値の表から学ぶ方法で、文章を作る生成AIには金額を出させていません。
- 予測の誤差が9.2%なら、見積に使ってよいですか?
- 平均で9.2%でも、外れの大きい件が残ります。予測は積み上げと並べて差の大きい件を探すのに使い、金額は人が決めます。
関連記事
この数字はどう出したか
このページの実験と計算の数字は、実際のお客さまの取引ではなく、架空のデータや架空の入力例から主宰が出したものです。予測の誤差は、架空の過去見積300件で学び、テスト400件で測る手順を20回くり返した中央値(MAPE)で、実データではこれより大きくなります。計算はPythonのコード(scripts/figsの再現コードと、画面の計算機と同じ式のsrc/lib/calc.ts)で組み、同じ入力なら同じ数字が出ます。
更新 ・ 事実の確認
出典
- 見積帳場の実験(2026年10月16日)。計算ルールにベテランの揺らぎ(対数正規σ0.08)を足した架空の過去見積で、5つの方法を学習50・100・200・300件、テスト400件、20回で比較。scripts/figs/ai_price_prediction.py(2026年10月16日確認)
- Arıkan ほか「Machine Learning-Based Manufacturing Cost Prediction from 2D Engineering Drawings via Geometric Features」arXiv:2508.12440v1(2025年8月、査読前。自動車部品の図面13,684枚・24グループ)(2026年10月16日確認)